

기업의 AI 도입이 시범 단계를 지나 운영 단계로 넘어가면서, 애플리케이션이 만들어내는 트래픽의 성격도 달라지고 있습니다. 하나의 애플리케이션이 하나의 모델을 호출하고 하나의 API 키를 관리하던 구조에서, 여러 모델 제공 업체와 프롬프트 중심 애플리케이션, 초기 단계의 에이전트 시스템이 동시에 돌아가는 구조로 바뀌었습니다. 문제는 이 트래픽 대부분이 애플리케이션 코드에서 모델 제공 업로 곧장 흘러간다는 점입니다. 중간에 정책을 적용할 지점이 없으면 보안팀은 검사할 위치를 확보하지 못하고, 토큰 사용량은 계측되지 않은 채 증가하며, 제공 업체를 하나 추가할 때마다 담당자가 불분명한 연동이 늘어납니다.
콩(Kong)은 이 문제를 프록시 관점으로 정리했습니다. 애플리케이션과 AI 제공 업체 사이의 모든 요청을 리버스 프록시를 거치도록 만들고, 그 지점에서 보안과 거버넌스, 비용 통제를 적용하자는 접근입니다. 이 글에서는 콩이 제시한 세 가지 AI 트래픽 패턴과 통합 프록시가 수행해야 하는 역할, 그리고 단계별 도입 방식을 정리합니다.
☑️ AI 트래픽 프록시란 무엇인가
AI 트래픽을 프록시한다는 것은 애플리케이션과 AI 제공 업체 사이의 모든 요청을 리버스 프록시로 라우팅하고, 그 지점에서 보안, 거버넌스, 비용 통제를 적용하는 것을 의미합니다. AI 게이트웨이는 이 역할을 수행하는 중앙 집중형 리버스 프록시로, 애플리케이션과 모든 AI 목적지 사이에 위치해 정책을 한 곳에서 적용합니다. 이렇게 하면 인증, 레이트 리밋, 비용 통제, 옵저버빌리티가 애플리케이션 코드가 아니라 인프라 계층에서 관리됩니다.
☑️ 직접 연동 방식에서 통제가 무너지는 이유
스탠퍼드 HAI의 2025 AI Index Report에 따르면 조직의 AI 도입률은 2024년 기준 78%로, 전년 55%에서 상승했습니다. 도입 규모가 커지면서 여러 제공 업체를 동시에 운영하는 환경이 일반화됐고, 콩은 여기서 세 가지 문제가 함께 커진다고 설명합니다.
보안 노출
애플리케이션 코드에서 모델 제공 업체로 직접 호출이 나가면 자격 증명과 프롬프트, 응답이 중앙 검사 지점 없이 네트워크를 통과합니다. 연동 하나하나가 공격 표면이 됩니다. API 키가 클라이언트 저장소에 남거나, 민감 데이터가 평문으로 네트워크 밖으로 나가면서 컴플라이언스 경계가 무너지는 상황이 대표적입니다.
비용 예측의 어려움
토큰 소비량은 예측하기 어렵고 남용되기 쉽습니다. 가트너는 2025년 3월 발표에서 전 세계 생성형 AI 지출이 2025년 6,440억 달러에 이를 것으로 전망했고, 2025년 9월 발표에서는 전체 AI 지출이 1조 5천억 달러 수준에 이를 것으로 추정했습니다. 두 수치 모두 발표 시점의 전망치이지만, 지출 규모가 이사회 차원의 리스크로 다뤄지는 단계에 들어섰다는 점은 분명합니다. 동일한 질의가 캐시 없이 반복적으로 모델을 호출하면 그만큼 예산이 소모됩니다.
운영 취약성
제공 업체마다 SDK와 인증 모델, 레이트 리밋 동작이 다릅니다. 연동 단위로 거버넌스를 덧붙이는 방식으로는 일관성을 유지하기 어렵습니다. 프록시 없이 제공 업를 하나 더 추가하려면 인증 처리를 중복 구현하고, 레이트 리밋 로직을 다시 작성하며, 모델을 호출하는 모든 서비스를 수정해야 합니다. 설정 변경으로 끝났어야 할 작업이 코드 변경으로 바뀌고, 그 부담이 AI 기능을 개발하는 모든 팀에 반복됩니다.
☑️ 통제해야 할 세 가지 AI 트래픽 패턴
콩은 운영 단계의 AI 환경에서 플랫폼 팀이 통제해야 할 라우팅 유형을 세 가지로 구분합니다. 각 패턴은 보안과 비용, 오케스트레이션 측면에서 서로 다른 성격을 가집니다.
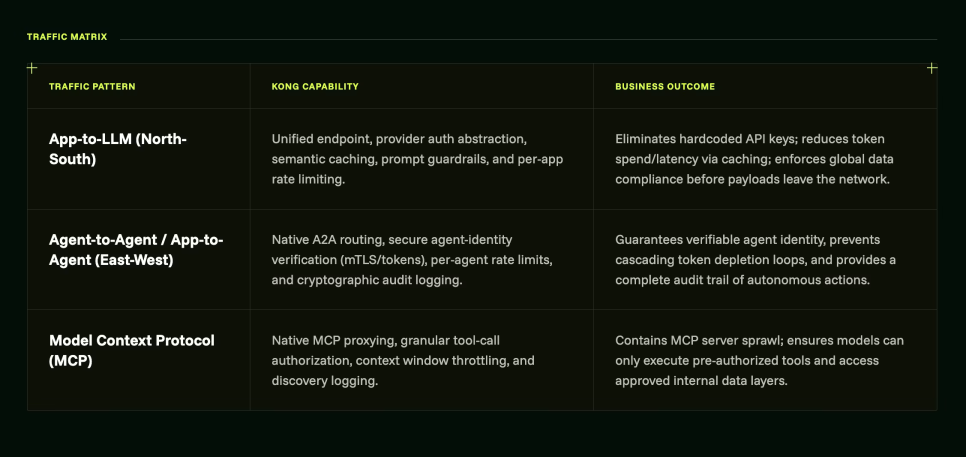
앱-LLM 트래픽 (North-South)
애플리케이션에서 모델 제공 업체로 향하는 직접 경로입니다. 챗봇이 외부 LLM API를 호출하는 형태가 여기에 해당합니다. 이 경로에는 중앙 집중형 인증, 애플리케이션 단위 레이트 리밋, 로깅, 가드레일이 필요합니다. 이 경로는 원본 데이터 페이로드를 직접 다루기 때문에, 프록시가 연결과 내용을 함께 통제해야 합니다. 인프라 측면의 제어(중앙 인증, 제공 업 장애 시 페일오버, 레이트 리밋)와 데이터 측면의 가드레일(PII 정제, 시맨틱 캐싱, 프롬프트 인젝션 방어)이 함께 적용되어야 한다는 의미입니다.
에이전트 간 트래픽 A2A (East-West)
자율 에이전트 사이의 통신입니다. 하나의 에이전트가 다른 에이전트에 작업을 위임하는 형태이며, 서비스 경계를 넘거나 조직 경계를 넘어 발생하기도 합니다. 이 영역의 거버넌스에는 검증 가능한 에이전트 신원 확립, 에이전트 단위의 권한 경계 적용, 그리고 연쇄적으로 토큰을 소진시키는 무한 루프의 차단이 필요합니다. 통제 지점이 없으면 에이전트가 암호학적 신원 검증 없이 다른 시스템을 대신해 작업을 수행하게 되고, 기업은 빠르게 늘어나는 비인간 트래픽을 파악하지 못하는 상태에 놓입니다.
MCP 트래픽
MCP(Model Context Protocol) 트래픽은 자율 에이전트를 로컬 데이터 소스, 파일 시스템, 개발 도구에 연결하는 경로입니다. 에이전트가 작업을 수행하기 위해 호출하는 대상들입니다. 이 프로토콜을 프록시하려면 프로토콜을 인식하는 인증, 도구 호출 단위의 세분화된 인가, 컨텍스트 윈도우 임계값 관리가 필요합니다. 모델이 무엇을 볼 수 있고 무엇을 할 수 있는지의 범위를 안전하게 제한하기 위해서입니다. 통제 없이 두면 조직 곳곳에서 섀도우 MCP 서버가 생겨나고, 에이전트가 내부 인프라에 감사 기록 없이 접근하는 상태가 됩니다.
☑️ 통합 AI 프록시가 수행하는 다섯 가지 기능
콩은 모든 AI 요청의 단일 인그레스이자 이그레스 지점으로 동작하는 프록시가 갖춰야 할 기능을 다섯 가지로 정리했습니다. 애플리케이션과 에이전트, 도구가 제공 업체를 직접 바라보는 대신 이 지점을 바라보게 하고, 요청이 목적지에 도달하기 전에 정책을 적용하는 구조입니다.
첫째, 통합 엔드포인트 추상화입니다. 모든 제공 업 앞에 하나의 안정적인 API를 두어, 애플리케이션이 특정 벤더를 코드에 고정하지 않도록 합니다.
둘째, 멀티 프로바이더 로드 밸런싱입니다. 애플리케이션 코드를 건드리지 않고 모델 간 라우팅과 페일오버를 수행합니다.
셋째, 토큰 단위 레이트 리밋입니다. 요청 수가 아니라 토큰 기준으로 소비량을 제한해 실제 비용을 통제합니다.
넷째, 시맨틱 프롬프트 캐싱입니다. 의미가 동일한 프롬프트에 대해 캐시된 응답을 반환해 지연 시간과 지출을 줄입니다.
다섯째, MCP와 A2A를 위한 프로토콜 인식 라우팅입니다. 에이전트 및 도구 프로토콜을 일반 HTTP가 아니라 해당 프로토콜로 처리합니다.
☑️ API 게이트웨이와 AI 게이트웨이는 무엇이 다른가
API 게이트웨이는 서비스 간 요청과 응답 트래픽을 보호하고 라우팅하지만, 토큰이나 프롬프트, 모델 제공 업, 에이전트 프로토콜이라는 개념을 갖고 있지 않습니다. AI 게이트웨이는 여기에 AI 특화 계층을 더합니다. 토큰 단위 레이트 리밋, 시맨틱 캐싱, 프롬프트 가드, 프로토콜 인식 라우팅이 그 계층에 해당합니다. 인증과 인가, 옵저버빌리티, 레이트 리밋처럼 플랫폼 팀이 기대하는 기존 통제 기능은 그대로 유지하면서, 단일 컨트롤 플레인에서 AI 특화 기능을 함께 적용하는 것이 AI 트래픽 관리의 핵심입니다.
☑️ Kong AI Gateway가 세 가지 트래픽을 처리하는 방식
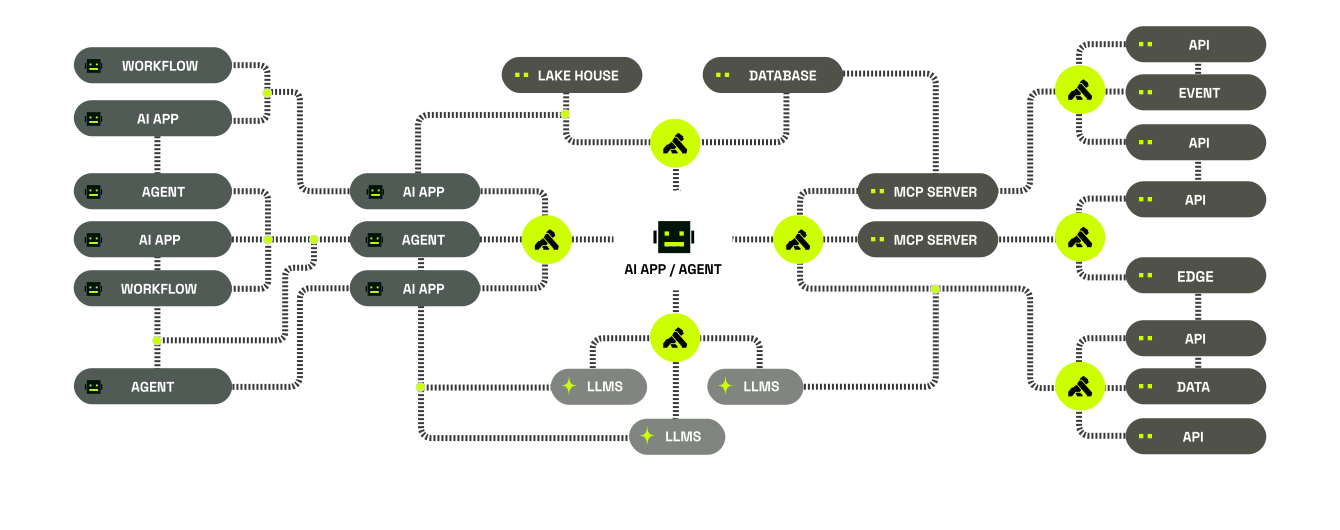
콩 AI 게이트웨이(Kong AI Gateway)는 LLM, MCP, A2A 트래픽을 하나의 게이트웨이에서 통제하는 것을 제품 방향으로 제시하고 있습니다. 각 패턴이 하나의 런타임 위 기능으로 매핑되는 구조입니다.
LLM 거버넌스
개발자와 애플리케이션, 에이전트가 LLM을 소비하는 방식을 통제하는 영역입니다. 접근 권한부터 데이터 유출, 토큰 사용량까지를 대상으로 합니다. 제품 페이지 기준으로 PII 정제를 통한 데이터 유출 차단, 시맨틱 캐싱과 라우팅, 로드 밸런싱을 통한 LLM 트래픽 효율화, 시맨틱 프롬프트 가드와 접근 제어를 통한 리소스 보호가 제시되어 있습니다. 제공 업체 인증은 게이트웨이가 추상화하므로 자격 증명이 애플리케이션 코드에 남지 않습니다. 시맨틱 캐시는 의미가 동일한 프롬프트에 대해 캐시된 응답을 제공하며, 콩 자료 기준으로 3~10배 수준의 지연 시간 개선과 그에 비례한 비용 절감을 제시하고 있습니다.
MCP 거버넌스
MCP 서버를 생성하고, 에이전트가 이를 탐색하고 소비하는 방식을 통제하는 영역입니다. Kong이 관리하는 API 위에서 MCP 도구와 서버를 자동 생성하고, MCP 서버 접근 제어를 위한 인증을 적용하며, MCP 컨텍스트 최적화를 통해 토큰 지출을 조정하는 기능이 제품 페이지에 명시되어 있습니다. MCP 트래픽에는 호출 단위 인가가 적용됩니다.
A2A 거버넌스
멀티 에이전트 트래픽을 대상으로 인증과 옵저버빌리티, 감사 추적을 적용하는 영역입니다. 모든 A2A 트래픽을 관측하고 A2A 고유 지표를 수집하며, 호출별로 페이로드와 지연 시간, 토큰 사용량, 오류를 포함한 텔레메트리를 확보합니다. A2A 트래픽 전반에 중앙 집중형 인증과 인가를 적용하고, 호출자 신원과 호출된 기능 정보를 포함해 모든 A2A RPC 호출을 감사하고 추적할 수 있도록 지원합니다.
토큰 쿼터와 AI 옵저버빌리티
세 패턴 아래에서 공통으로 동작하는 영역입니다. 멀티 LLM 로드 밸런싱은 OpenAI, Anthropic, Gemini, Mistral 및 자체 호스팅 모델에 걸쳐 적용되며, 토큰 단위 레이트 리밋으로 지출을 제한합니다. 쿼터 관리 측면에서는 사용자, 모델, 기간 단위로 LLM 소비량과 토큰 지출에 대한 쿼터를 설정하고 게이트웨이 계층에서 이를 적용할 수 있습니다. LLM과 에이전트, MCP 사용량에 대한 쇼백과 차지백 체계를 구성하는 것도 가능합니다. 옵저버빌리티 측면에서는 AI 소비량과 도구 사용, 토큰 지출을 추적하고, 로깅과 트레이싱을 통해 AI 노출 지점을 확인할 수 있습니다.
☑️ 단계별 도입 접근
세 가지 패턴을 처음부터 모두 통제할 필요는 없습니다. 콩은 단계적 적용 방식을 제시합니다.
1단계는 앱-LLM 트래픽의 중앙화입니다. 애플리케이션이 게이트웨이를 바라보도록 전환하고, 제공 업체 자격 증명을 코드 밖으로 옮기며, 애플리케이션 단위 로깅과 레이트 리밋을 활성화합니다. 이 단계만으로도 가장 큰 보안 공백이 닫힙니다.
2단계는 비용 통제 추가입니다. 시맨틱 캐싱과 토큰 단위 레이트 리밋을 적용해 반복 프롬프트에 소모되는 지출을 줄이고, 통제되지 않는 소비량이 청구서에 반영되기 전에 상한을 설정합니다.
3단계는 에이전트와 MCP로의 확장입니다. A2A와 MCP 트래픽을 같은 컨트롤 플레인 아래로 편입하고, 해당 패턴이 운영 단계에 진입하는 시점에 맞춰 에이전트 신원, 도구 호출 인가, 감사 로깅을 추가합니다.
이 구조에서는 제공 업를 전환하거나 추가하는 작업이 코드 변경이 아니라 설정 변경이 됩니다.
☑️ 자주 묻는 질문
AI 게이트웨이란 무엇인가요?
AI 게이트웨이는 애플리케이션과 AI 제공 업체 사이의 트래픽을 라우팅하고 통제하는 중앙 집중형 리버스 프록시입니다. LLM 호출, 프롬프트, 에이전트 트래픽, 도구 호출에 대해 인증과 레이트 리밋, 비용 통제, 옵저버빌리티를 적용하며, AI 거버넌스를 애플리케이션 코드가 아닌 인프라 계층에서 관리하도록 합니다.
API 게이트웨이와 AI 게이트웨이는 어떻게 다른가요?
API 게이트웨이는 서비스 간 요청과 응답 트래픽을 보호하고 라우팅하지만 토큰, 프롬프트, 모델 제공 업, 에이전트 프로토콜이라는 개념이 없습니다. AI 게이트웨이는 기존 게이트웨이 기능 위에 토큰 단위 레이트 리밋, 시맨틱 캐싱, 프롬프트 가드, 프로토콜 인식 라우팅을 더합니다. 범용 API 게이트웨이만으로는 AI 트래픽을 통제하기 어렵기 때문입니다.
MCP 프록시란 무엇인가요?
MCP 프록시는 AI 에이전트와 MCP 서버 사이의 트래픽을 중앙 게이트웨이를 거치도록 라우팅하는 방식입니다. 프록시가 요청을 인증하고 개별 도구 호출을 인가하며, 컨텍스트 한도를 적용하고 모든 상호작용을 기록합니다. 플랫폼 팀은 이를 통해 에이전트가 접근할 수 있는 도구와 데이터 소스를 중앙에서 통제할 수 있습니다.
LLM API 호출은 어떻게 제한해야 하나요?
요청 수가 아니라 토큰 단위로 제한하는 것이 기준이 됩니다. 비용과 부하가 소비된 토큰에 비례해 증가하기 때문입니다. 게이트웨이가 애플리케이션, 팀, 에이전트 단위로 토큰 사용량을 계측하고, 요청이 제공 업체에 도달하기 전에 쿼터를 적용하는 방식입니다.
애플리케이션 코드를 수정하지 않고 여러 LLM 제공 업체를 관리하려면 어떻게 해야 하나요?
통합 엔드포인트를 제공하고 제공 업체별 인증과 API 차이를 추상화하는 AI 게이트웨이를 경유하도록 구성하면 됩니다. 애플리케이션은 하나의 인터페이스만 호출하고, 라우팅과 페일오버, 로드 밸런싱은 게이트웨이가 처리합니다. 이 구조에서는 제공 업를 추가하거나 전환하는 작업이 설정 변경 수준에서 이뤄집니다.
에이전트 간(A2A) 라우팅이란 무엇인가요?
A2A 라우팅은 자율 에이전트 사이의 통신을 통제하는 방식으로, A2A 프로토콜 기반 트래픽을 포함합니다. 게이트웨이가 에이전트 신원을 부여하고 검증하며, 에이전트 단위 레이트 리밋을 적용하고, 에이전트가 다른 에이전트를 대신해 수행한 작업의 감사 기록을 남깁니다. 에이전트 통신을 API와 동일한 수준의 운영 트래픽으로 다루는 접근입니다.
☑️ 마무리
운영 단계의 AI 환경은 앱-LLM, 에이전트 간 통신, MCP라는 세 가지 트래픽 패턴 위에서 동작합니다. 이를 연동 단위로 하나씩 관리하는 방식에서 보안 공백과 비용 통제 실패, 운영 복잡도가 생겨납니다. 세 패턴을 하나의 컨트롤 플레인에서 통제하는 프록시 구조가 필요한 이유입니다.
금융, 공공, 제조처럼 감사 추적과 데이터 통제 요건이 강한 환경에서는 도입 순서와 적용 범위를 함께 검토해야 합니다. 클라우드네트웍스는 고객 환경의 AI 트래픽 구조를 확인하고, 어느 패턴부터 통제 대상으로 삼을지, 기존 API 관리 체계와 어떻게 연결할지를 함께 검토하는 과정을 지원할 수 있습니다. Kong AI Gateway 도입을 검토 중이시라면 아래 링크를 통해 문의해 주시기 바랍니다.
▶ Kong AI Gateway 자세히보기
[출처 : Kong, "How to Proxy Every AI Traffic Pattern Through One Gateway", Kong, "Secure, Scalable AI Gateway for AI Connectivity", Stanford HAI, "The 2025 AI Index Report — Economy", Gartner, "Gartner Forecasts Worldwide GenAI Spending to Reach $644 Billion in 2025", Gartner, "Gartner Says Worldwide AI Spending Will Total $1.5 Trillion in 2025"]