

기업이 생성형 AI를 시범 단계에서 실제 서비스 운영 단계로 옮기면서, 클라우드 비용에서 GPU가 차지하는 비중이 빠르게 커지고 있습니다. 모델을 고르고 서빙 환경을 구성하는 일까지 마쳤는데, 청구서를 열어보면 예상보다 큰 금액이 찍혀 있는 상황이 반복됩니다.
문제는 GPU를 얼마나 많이 샀느냐가 아니라, 확보한 GPU를 얼마나 쓰고 있느냐에 있습니다. Cast AI가 AWS, Azure, GCP에 걸친 수천 개 클러스터를 분석한 2026 State of Kubernetes Optimization Report에 따르면 프로덕션 쿠버네티스 클러스터의 평균 GPU 사용률은 5퍼센트입니다. GPU는 실제로 얼마나 일했는지와 관계없이 시간당 요금 전액이 청구되므로, 나머지 95퍼센트는 비용만 발생시키고 있는 용량입니다.
이 격차는 하드웨어를 새로 늘리지 않고도 좁힐 수 있습니다. 쿠버네티스 환경의 LLM 추론 비용을 줄이는 방법은 다섯 가지로 정리됩니다. GPU 공유와 연속 배칭, 양자화, 라이트사이징, 오토스케일링이며, 각 방법이 해결하는 문제와 운영 환경에서 확인해야 할 지점, Cast AI의 자동화 방식까지 순서대로 정리했습니다.
☑️ LLM 추론 비용 최적화란 무엇인가
LLM 추론 비용 최적화는 쿠버네티스에서 대규모 언어 모델을 서빙하는 데 드는 GPU 연산과 메모리 비용을 줄이는 방법을 말합니다. GPU 공유와 배칭으로 사용 효율을 높이고, GPU 요청을 실제 사용량에 맞게 조정하며, 추론 엔드포인트를 수요에 맞춰 자동으로 늘리고 줄이는 방식이 포함됩니다. 유휴 상태일 때 레플리카를 0으로 내리는 scale-to-zero도 여기에 해당합니다.
핵심은 추론 지출의 대부분이 실제 연산이 아니라 놀고 있는 용량에 쓰인다는 점입니다. 따라서 비용을 줄이는 출발점은 모델을 바꾸는 것이 아니라, 이미 확보한 GPU가 요청과 요청 사이에 멈춰 있는 시간을 줄이는 데 있습니다.
☑️ GPU 사용률이 추론 비용을 결정하는 이유
같은 하드웨어에서 처리 방식만 바꿔도 토큰당 비용이 크게 달라집니다. Llama 3.1 70B를 H100 한 장에서 단일 스트림 방식으로 실행하면 백만 토큰당 약 0.60~0.80달러가 듭니다. 배치 크기 8의 연속 배칭을 적용하면 같은 조건에서 백만 토큰당 0.15~0.25달러로 내려갑니다. GPU가 빨라진 것이 아니라, 요청 사이에 GPU를 놀리지 않게 된 결과입니다.
이 수치는 Cast AI 벤치마크 조건에서 측정된 값입니다. Llama 3.1 70B FP8, H100 80GB SXM5, vLLM 0.5 이상, 512토큰 프롬프트와 256토큰 출력, AWS eu-west-1 리전의 H100 스팟 가격 시간당 약 2~4달러(2025년) 기준입니다. 절감폭은 약 2K 토큰 이하의 짧은 컨텍스트에서 확인되며, 컨텍스트가 길어지면 KV 캐시가 가중치 메모리와 경쟁하면서 유지할 수 있는 배치 크기가 줄어듭니다.
사용률 격차는 클라우드별로도 나타납니다. Cast AI 측정 기준 Azure AKS는 2퍼센트, Amazon EKS는 5퍼센트, Google GKE는 6퍼센트였습니다. 같은 데이터셋에서 가장 높은 사용률을 기록한 클러스터는 136노드 H200 구성으로 49퍼센트에 도달했습니다. 5퍼센트와 49퍼센트의 차이는 하드웨어를 교체하지 않고도 좁힐 수 있는 폭입니다.
유휴 자원의 비용은 계산해 보면 더 분명해집니다. H100 스팟 가격은 클라우드와 리전에 따라 시간당 2~6달러 범위이며, 시간당 3달러로 잡아도 유휴 레플리카 한 개가 월 2,160달러를 소모합니다. 주요 클라우드의 온디맨드 가격인 시간당 8~12달러 기준으로는 월 5,760~8,640달러입니다. 레플리카 한 개 기준의 금액입니다.
☑️ GPU 사용률을 높이는 다섯 가지 접근 방식
1. GPU 공유 : MIG와 타임슬라이싱
A100 80GB 한 장은 여러 개의 독립적인 추론 워크로드를 동시에 수용할 수 있습니다. NVIDIA MIG(Multi-Instance GPU)는 물리 GPU 하나를 하드웨어 수준에서 격리된 파티션으로 나누며, 각 파티션은 전용 메모리와 연산 자원, L2 캐시를 갖습니다. 가상화가 아니라 독립된 물리 디바이스처럼 동작하는 방식입니다.
A100 80GB의 MIG 프로파일은 다음과 같이 구분됩니다.
| 프로파일 | 메모리 | 수용 가능한 모델 |
| 1g.10gb | 10GB | INT4/GPTQ 7B 모델(약 4~5GB) 또는 소형 임베딩 모델 |
| 2g.20gb | 20GB | 7B INT8(약 7GB), 13B INT8(약 13GB)에 KV 캐시 여유 확보 |
| 3g.40gb | 40GB | 약 30GB까지의 INT4/AWQ 모델. INT4 70B(약 35GB)는 파티션 한계에 근접 |
| 7g.80gb | 80GB 전체 | AWQ 정밀도의 70B 모델 또는 34B 이상 FP16/BF16 모델 |
주의할 제약이 하나 있습니다. 각 MIG 파티션은 독립된 모델 인스턴스를 실행하며, 하드웨어 격리 때문에 파티션 사이의 NVLink와 P2P CUDA 통신이 비활성화됩니다. 동일한 A100의 두 MIG 슬라이스에 걸쳐 텐서 병렬 처리를 구성하는 것은 구조적으로 불가능하므로, 70B 모델을 여러 장에 분할해야 한다면 MIG 파티션이 아니라 NVLink로 연결된 물리 GPU를 사용해야 합니다. 쿠버네티스에서는 nvidia-device-plugin이 MIG 파티션을 스케줄링 가능한 자원으로 노출하며, 3g.40gb 파티션을 대상으로 하는 배포는 리소스 스펙에 nvidia.com/mig-3g.40gb 자원을 요청하는 방식으로 구성합니다.
MIG를 지원하지 않는 T4, A10G, 구형 Ampere 카드에서는 타임슬라이싱이 대안이 됩니다. 타임슬라이싱은 하드웨어 분할이 아니라 스케줄링 수준에서 GPU 접근을 다중화하므로 여러 파드가 동일한 GPU 컨텍스트를 공유합니다. 테넌트 간 메모리 격리가 없어 노이지 네이버 영향이 실제로 발생하기 때문에, 지연에 민감한 프로덕션 추론보다는 개발 워크로드나 우선순위가 낮은 배치 작업에 적합합니다.
2. 연속 배칭, 추측 디코딩, 프리픽스 캐싱
정적 배칭은 배치가 다 찰 때까지 기다렸다가 요청을 한꺼번에 처리합니다. 오프라인 작업에는 맞는 방식이지만 온라인 추론에서는 짧은 요청이 긴 요청이 끝나기를 기다리게 만들어 처리량이 떨어지고 테일 레이턴시가 튑니다. 연속 배칭은 생성 과정을 개별 이터레이션의 흐름으로 다뤄 이 문제를 해결합니다. 배치 전체가 끝나기를 기다리지 않고 슬롯이 비는 즉시 새 요청이 배치에 합류하며, vLLM은 이 방식을 기본값으로 사용합니다. 동일한 하드웨어 예산에서 정적 배칭 대비 3~5배 높은 처리량을 내며, 길이가 섞인 워크로드에서 P99 레이턴시도 낮아집니다.
추측 디코딩은 작은 드래프트 모델이 여러 토큰을 미리 제안하고 메인 모델이 한 번의 포워드 패스로 검증하는 방식입니다. 자기회귀 LLM의 토큰 생성은 연산이 아니라 메모리 대역폭에 묶여 있기 때문에, 드래프트 토큰 여러 개를 검증하는 비용이 하나를 검증하는 비용과 거의 같습니다. 제안이 맞으면 한 번의 포워드 패스에서 여러 토큰을 얻습니다. 배치 크기 1~2의 채팅 인터페이스나 코파일럿 도구처럼 요청당 지연이 중요한 환경에서 생성 레이턴시를 30~50퍼센트까지 줄일 수 있습니다. 동시성이 높아지거나 배치 크기가 커지면 드래프트 모델을 병렬로 돌리는 부담 때문에 순이익이 줄어들므로, 실제 요청 동시성 수준에서 효과를 측정한 뒤 적용해야 합니다.
프리픽스 캐싱은 반복되는 프롬프트 앞부분의 KV 상태를 GPU 메모리에 저장해 재사용합니다. 대부분의 채팅과 RAG 워크로드는 모든 요청에 동일한 시스템 프롬프트를 함께 보내는데, 캐싱이 없으면 모델이 매 호출마다 그 프리픽스의 KV 상태를 다시 계산합니다. 70B 모델에 512토큰 시스템 프롬프트를 사용하는 환경이라면 프리필 연산 낭비가 상당합니다. 긴 공통 시스템 프롬프트를 쓰는 채팅이나 RAG 배포에서 프리픽스 캐싱은 반복 질의의 프리필 연산을 60~80퍼센트까지 제거합니다. 첫 토큰까지의 시간이 줄고 같은 하드웨어에서 실효 처리량이 올라갑니다.
3. 양자화와 토큰당 비용
양자화는 모델 가중치를 저장하는 수치 정밀도를 낮추는 방식입니다. 파라미터당 비트 수가 줄면 VRAM 사용량이 작아지고 메모리 처리량이 올라가며, 하드웨어에 따라서는 연산 가속까지 받습니다. 대신 정밀도가 낮아지면서 생기는 반올림 오차가 레이어를 거치며 누적됩니다.
어떤 포맷이 적합한지는 GPU 아키텍처에 따라 달라집니다.
| GPU | 아키텍처 | 권장 포맷 | 특징 |
| H100 80GB, H200 | Hopper | FP8 | 네이티브 FP8 텐서 코어 지원. BF16 대비 VRAM 절반, 처리량 1.5~1.8배 |
| A100 80GB (프로덕션 70B) | Ampere | AWQ / INT4 | AWQ 4비트로 70B를 약 35~37GB로 축소, 80GB 중 약 40GB를 KV 캐시에 확보 |
| A100 80GB (소형 모델 또는 정확도 우선) | Ampere | INT8 | 파라미터당 1바이트 유지. 70B INT8은 약 70GB로 KV 캐시 여유가 거의 없음 |
| T4, L4, A10G | Turing / Ampere | INT4 / GPTQ / GGUF | VRAM 16~24GB 제약. 소형 모델 위주, 정확도 손실이 더 큼 |
VRAM 계산이 중요합니다. 70B 모델을 FP16/BF16으로 실행하면 가중치만 약 140GB가 필요하지만, A100 80GB에서 AWQ 4비트를 적용하면 약 35~37GB로 줄어 KV 캐시와 활성값에 약 40GB가 남습니다. FP8 추론을 하려면 네이티브 FP8 하드웨어 지원이 있는 H100 80GB나 H200이 필요하며, A100에서 소프트웨어 에뮬레이션으로 FP8을 돌리면 처리량 이점 없이 출력 품질만 떨어집니다. 정확도 손실 폭은 포맷과 모델 계열, 작업 유형에 따라 달라집니다. H100/H200의 FP8은 BF16 대비 MMLU 정확도 하락이 대체로 1퍼센트 미만이고, A100의 AWQ는 1~3퍼센트, INT4(GPTQ/GGUF)는 3~6퍼센트 수준입니다. AWQ는 가장 민감한 가중치 채널을 식별해 보호하기 때문에 단순 INT8보다 정확도를 잘 유지합니다. 어느 포맷이든 프로덕션 배포 전에 실제 모델과 과제로 벤치마크를 거쳐야 합니다.
4. GPU 요청 라이트사이징
쿠버네티스 GPU 배포에서 과다 프로비저닝은 기본 동작에 가깝습니다. 9GB를 사용하는 워크로드에 H100 80GB를 요청하면 GPU는 8퍼센트 사용률로 돌아가고 요금은 100퍼센트로 청구됩니다. 이 패턴은 규모가 커질수록 플릿 전반에서 반복됩니다.
라이트사이징은 자원 선언을 최악의 가정이 아니라 실제 피크 사용량에 맞추는 작업입니다. 추론 워크로드에서 확인해야 할 지표는 세 가지입니다.
GPU 메모리 사용률은 nvidia-smi나 DCGM exporter로 컨테이너 단위로 측정합니다. 40GB를 요청했지만 피크가 18GB인 파드는 더 작은 파티션이나 인스턴스 타입으로 옮기는 것이 맞습니다. SM 사용률은 모델이 연산에 묶여 있는지 메모리 대역폭에 묶여 있는지를 보여줍니다. 대부분의 추론 워크로드는 연산이 아니라 메모리 대역폭에 묶이기 때문에, SM 사용률이 낮은데 메모리 대역폭 사용률이 높은 상태는 낭비가 아니라 정상 동작입니다. 이 지표만 보고 자원을 줄이면 판단을 그르칠 수 있습니다. 토큰 처리량과 SLO 대비 수준은 오토스케일러 임계값 설정의 기준이 됩니다. 레플리카당 최소 초당 토큰 목표를 정의하고, 목표 아래로 떨어지면 레플리카를 늘리고 목표를 크게 웃돌면 인스턴스 크기를 줄이는 방식입니다.
흔한 실수 하나는 MIG 프로파일이나 인스턴스 타입을 지정하지 않고 nvidia.com/gpu 자원 하나만 요청하는 경우입니다. 이렇게 두면 스케줄러가 가용한 아무 GPU에나 파드를 배치할 수 있어, 7B INT4 모델이 H100 80GB에 올라가는 상황이 생깁니다. 명시적인 자원 라벨과 노드 셀렉터, 노드 어피니티 규칙으로 워크로드를 올바른 GPU 등급에 묶어야 합니다.
5. 오토스케일링과 scale-to-zero
유휴 GPU 레플리카는 추론 예산에서 가장 비싼 항목입니다. 축소되지 않는 정적 배포는 쓰지 않는 용량에 대해 계속 과금됩니다. 쿠버네티스 HPA는 기본적으로 CPU와 메모리를 기준으로 스케일링하는데, 두 지표 모두 GPU 추론 워크로드에서는 의미 있는 신호가 아닙니다. LLM 추론에 맞는 오토스케일링은 추론 고유의 신호를 사용합니다.
큐 깊이는 슬롯을 기다리는 추론 요청의 수로, 큐가 길어지는 것은 레이턴시가 나빠지기 전에 용량 부족을 알려주는 선행 신호입니다. 레플리카당 초당 토큰은 SLO 목표 아래로 지속적으로 떨어지면 스케일 아웃을, 목표를 지속적으로 웃돌면 스케일 인을 유발하는 기준이 됩니다. GPU 메모리 압박은 KV 캐시 사용률로 확인하며, 80퍼센트를 넘으면 OOM으로 인한 축출이나 KV 캐시 축출 정책에 따른 품질 저하가 다가오고 있다는 신호입니다. KEDA(Kubernetes Event-Driven Autoscaler)는 Prometheus 기반 커스텀 메트릭을 지원하기 때문에 추론 인지형 오토스케일링의 표준 선택지로 쓰입니다.
가장 강한 형태의 비용 통제는 scale-to-zero입니다. 개발 엔드포인트나 내부 도구, 트래픽이 적은 모델은 유휴 상태에서 레플리카를 0으로 내리면 유지 비용이 사라집니다. 대가는 콜드 스타트 지연입니다. A100 80GB에서 70B AWQ 모델을 오브젝트 스토리지에서 GPU 메모리로 로드하는 데 스토리지 대역폭에 따라 30~90초가 걸립니다. 지연에 민감한 워크로드는 워밍 레플리카를 최소 하나 유지하고, 배치나 비동기 워크로드는 scale-to-zero를 기본값으로 두는 편이 합리적입니다.
☑️ Cast AI는 이 다섯 가지를 어떻게 지원하는가
다섯 가지 접근 방식을 수동으로 구현하면 관리해야 할 도구와 설정, 대응 경로가 각각 다섯 개로 늘어납니다. Cast AI는 이 작업들을 하나의 제어 평면에서 동시에 자동화합니다.
GPU 공유 : 세 가지 분할 방식과 자동 배치
Cast AI는 타임슬라이싱과 MIG 두 가지 방식으로 GPU를 공유하고 분할합니다. 타임슬라이싱은 모든 NVIDIA GPU에서 사용할 수 있으며 GPU당 1개에서 48개까지 레플리카를 구성하고, 워크로드 밀도에 맞춰 공유 비율을 GPU 타입별로 다르게 설정할 수 있습니다. MIG는 A100, A30, H100에서 하드웨어 격리 파티션을 만들며, 각 파티션이 전용 연산 코어와 메모리를 갖기 때문에 노이지 네이버 문제가 발생하지 않습니다. 두 방식은 조합할 수도 있습니다. 7개 MIG 파티션 각각에 4-way 타임슬라이싱을 적용하면 A100 한 장에서 28개 워크로드를 동시에 운영할 수 있어, 모델 버전을 여러 개 서빙하거나 A/B 테스트를 돌리는 추론 환경처럼 파티션 하나도 다 채우지 못하는 워크로드에 유효합니다.
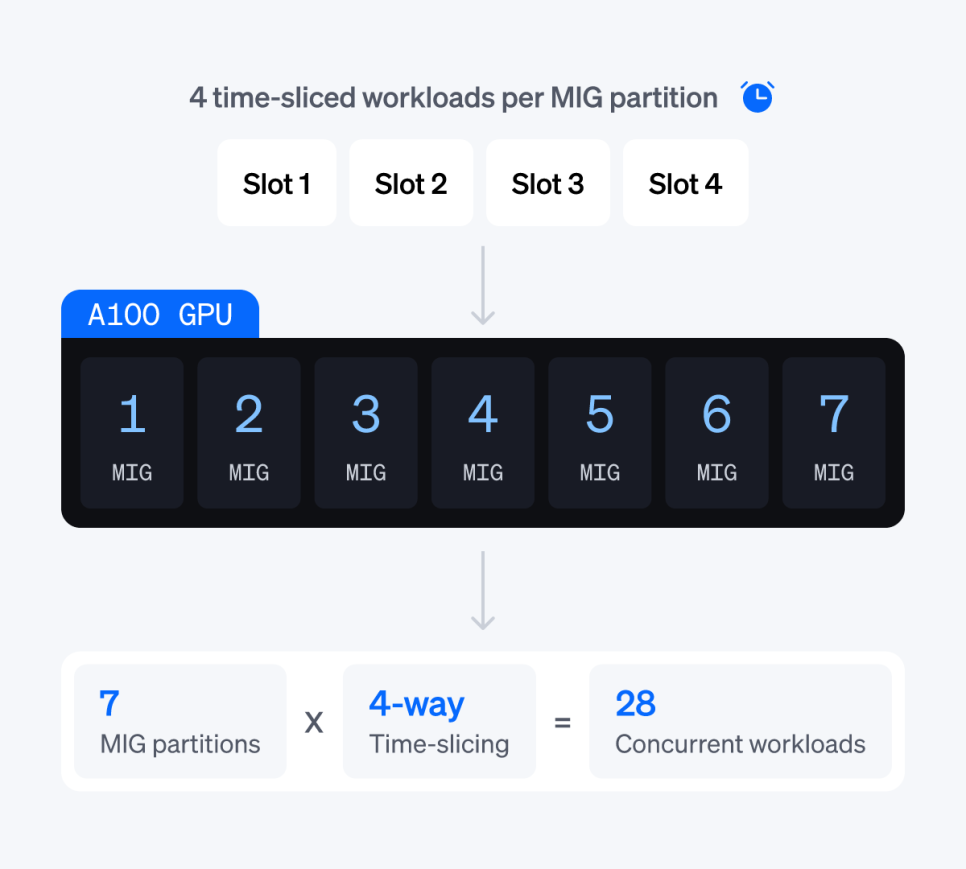
클라우드별 지원 범위에는 차이가 있습니다. 타임슬라이싱은 AWS EKS와 GCP GKE에서 지원되며 EKS는 Amazon Linux 2023 또는 Bottlerocket이 필요하고, MIG는 EKS와 GKE에서 지원되며 EKS는 Bottlerocket을 요구합니다. AWS G6 인스턴스에서는 사전 분할된 Fractional GPU를 사용할 수 있습니다. 설정은 노드 템플릿에서 이뤄지므로 워크로드 매니페스트를 수정할 필요가 없습니다. 애플리케이션은 평소처럼 자원을 요청하고, 공유 구성은 인프라 계층에서 관리됩니다.
여기에 배치 엔진이 붙습니다. Cast AI는 공유되고 분할된 GPU 전반에 워크로드를 자동으로 빈패킹하며, 새 노드를 늘리기 전에 기존 노드의 사용률을 먼저 채웁니다. MIG 파티션과 공유 설정, 워크로드 요구사항을 함께 고려하는 배치 알고리즘이므로 매니페스트에 스케줄링 로직을 넣지 않아도 됩니다.
자원 요청 라이트사이징 : 재시작 없이 적용
수동 라이트사이징은 느리고 위험 부담이 있어, 팀은 안전한 쪽을 택해 자원을 여유 있게 잡아두게 됩니다. Cast AI 워크로드 오토스케일러는 과거 지표와 실시간 지표를 함께 분석해 CPU와 메모리 요청을 실제 사용 패턴에 맞춥니다. 실행 중인 파드의 자원 할당을 재시작 없이 변경하는 in-place 파드 리사이징을 지원하기 때문에 조정 과정에서 서비스가 끊기지 않으며, 변경을 바로 적용하는 즉시 모드와 유지보수 시간대나 트래픽이 적은 시간에 적용하는 지연 스케일링 모드를 선택할 수 있습니다. 예상치 못한 트래픽 급증에는 자동으로 자원을 확대해 대응합니다.
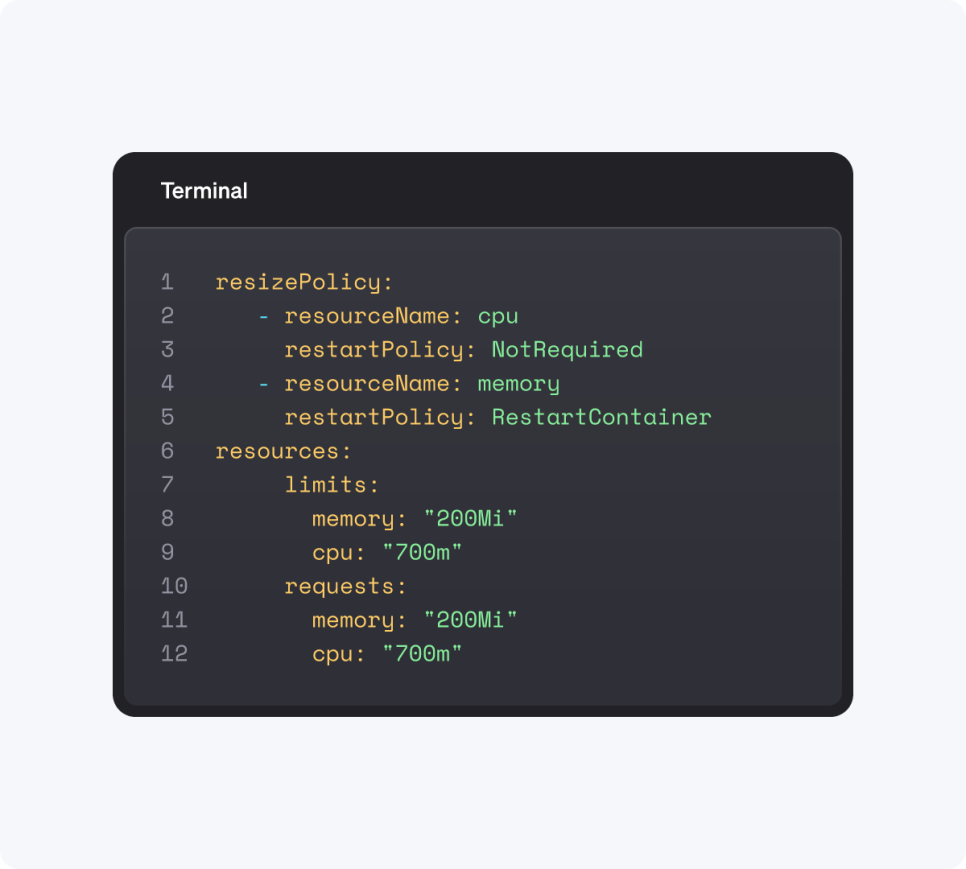
수직 스케일링과 수평 스케일링은 함께 쓰면 충돌하기 쉬운 조합입니다. 워크로드 오토스케일러는 HPA와 VPA를 결합하면서 둘 사이의 충돌을 조정해 단기 수요 급증과 장기 추세를 함께 반영하고, 메모리 부족으로 인한 크래시는 적응형 메모리 조정으로 사전에 방지합니다. 적용 대상은 Deployment, StatefulSet, Job, CronJob이며 라벨 기반 선택으로 커스텀 워크로드까지 포함합니다. 퍼시스턴트 스토리지를 사용해 이동이 어려웠던 워크로드는 컨테이너 라이브 마이그레이션으로 노드 간 이동이 가능해지며, 이는 노드 조각화를 줄여 빈패킹 여지를 넓히는 역할도 합니다.
Cast AI가 공개한 수치 기준으로 최적화 전 평균 CPU 사용률은 8퍼센트이며, 자동 라이트사이징 적용 이후 OOM kill은 거의 발생하지 않았습니다. 고객들이 확인하는 클라우드 비용 절감폭은 30~70퍼센트 범위이며, 이 수치는 Cast AI 2026 State of Kubernetes Optimization Report와 Akamai, Wio Bank 등 고객 사례를 근거로 합니다. GPU 자원에 대해서는 DCGM 메트릭을 지속적으로 읽어 관측된 워크로드 동작을 근거로 권고를 만듭니다. 정적 규칙이 아니라 실제 측정값에 기반하므로, 여러 모델 크기가 섞인 공유 클러스터에서도 수동 프로파일링 주기를 돌리지 않고 프로비저닝 용량과 실제 소비량의 격차를 줄일 수 있습니다.
노드 라이프사이클 : 파드가 아니라 노드를 내린다
오토스케일링에서 HPA와 갈리는 지점은 노드입니다. HPA는 파드를 축소하지만 하단 노드는 과금을 계속합니다. Cast AI 워크로드 오토스케일링은 GPU 노드 라이프사이클 관리와 직접 연동되어, 마지막 추론 레플리카가 내려가면 하단 GPU 노드를 해제해 과금을 멈추고 수요가 돌아오면 새 노드를 프로비저닝하면서 파드 스케줄링을 병렬로 진행합니다. scale-to-zero가 비용 절감으로 실제로 이어지려면 파드 축소가 노드 해제까지 닿아야 한다는 점에서 이 연동이 핵심입니다.
노드를 새로 띄울 때는 워크로드의 자원 요청을 읽어 스팟과 온디맨드 풀 전반에서 적합한 인스턴스 타입에 매칭합니다. 스팟 인스턴스를 우선 사용하되 회수 상황에서는 자동으로 폴백하는 구조이므로, 지연에 민감하지 않은 추론 작업에 스팟을 적용하면서도 운영 안정성을 유지할 수 있습니다. AI 수요는 튀는 성격이 강한데, GPU 용량 자체를 실제 워크로드 수요에 맞춰 지속적으로 늘리고 줄입니다. 배포 스펙에 MIG 자원 라벨을 선언하면 해당 파티션을 제공하는 노드 타입을 자동으로 프로비저닝하므로, 인스턴스를 수동으로 고르는 과정도 필요하지 않습니다.
GPU 용량 확보 : OMNI Compute for AI
앞의 세 가지가 이미 확보한 GPU를 얼마나 잘 쓰느냐의 문제라면, 그 앞에 놓인 문제가 하나 더 있습니다. 필요한 시점에 필요한 리전에 GPU가 없는 상황입니다. Cast AI는 이 경우를 비용 최적화가 아니라 용량 조달과 조정의 문제로 구분합니다.
OMNI Compute for AI는 기존 쿠버네티스 클러스터를 여러 클라우드와 리전의 GPU 용량으로 확장합니다. 원격 GPU 노드는 클러스터의 네이티브 노드로 합류하므로 애플리케이션 코드를 바꿀 필요가 없습니다. 연결은 Crossplane과 CRD 기반 프로비저닝을 통해 WireGuard 보안 연결 위에서 이뤄지고 설정에는 Terraform을 사용할 수 있으며, GPU 드라이버 설치는 노드가 올라오는 시점에 자동으로 처리됩니다. 오토스케일러는 노드를 프로비저닝하기 전에 메인 클러스터 리전과 연결된 모든 엣지 로케이션의 스팟 및 온디맨드 가격을 비교하고, 용량이 있으면서 비용이 가장 낮은 곳에 노드를 띄웁니다. 비용, 성능, 컴플라이언스 조건을 워크로드별로 설정할 수 있어 어디에서 실행할지에 대한 통제권은 유지됩니다.
이미 확보한 용량이 있는 조직이라면 조달 없이도 사용할 수 있습니다. 다른 계정의 예약 용량, 프라이빗 클라우드 노드, 자체 인프라를 기존 클러스터에 연결하고 배치와 공유, 가시성 관리만 맡기는 구성이 가능합니다. 기존 계약과 공급자를 유지한 상태에서 운영 방식만 바꾸는 방식입니다. 다만 워크로드 성격에 따라 적합도는 갈립니다. GPU 집약적 워크로드와 배치 처리, 데이터 처리 파이프라인, 스테이트리스 애플리케이션은 적합한 반면, 지연에 민감한 ML 학습 작업이나 퍼시스턴트 볼륨이 필요한 데이터베이스 워크로드는 적합하지 않습니다. 추론과 배치 워크로드가 OMNI의 주 대상인 이유입니다.
가시성 : 어디서 새고 있는지 먼저 확인
최적화를 이제 시작하는 단계라면 순서가 있습니다. 워크로드별 GPU 사용률과 메모리 사용량, 성능을 실시간으로 확인하고, 그 사용량을 워크로드와 팀, 애플리케이션 단위로 배분해 누가 무엇에 쓰고 있는지 파악하는 단계입니다. 유휴 용량을 찾아내고 최적화 권고를 제시하는 기능이 여기에 함께 붙습니다. 대부분의 팀은 이 단계에서 2~3개 워크로드가 GPU 지출의 대부분을 차지한다는 사실을 발견하며, 그 워크로드를 먼저 처리하면 이후 최적화 작업에 쓸 재원이 확보됩니다.
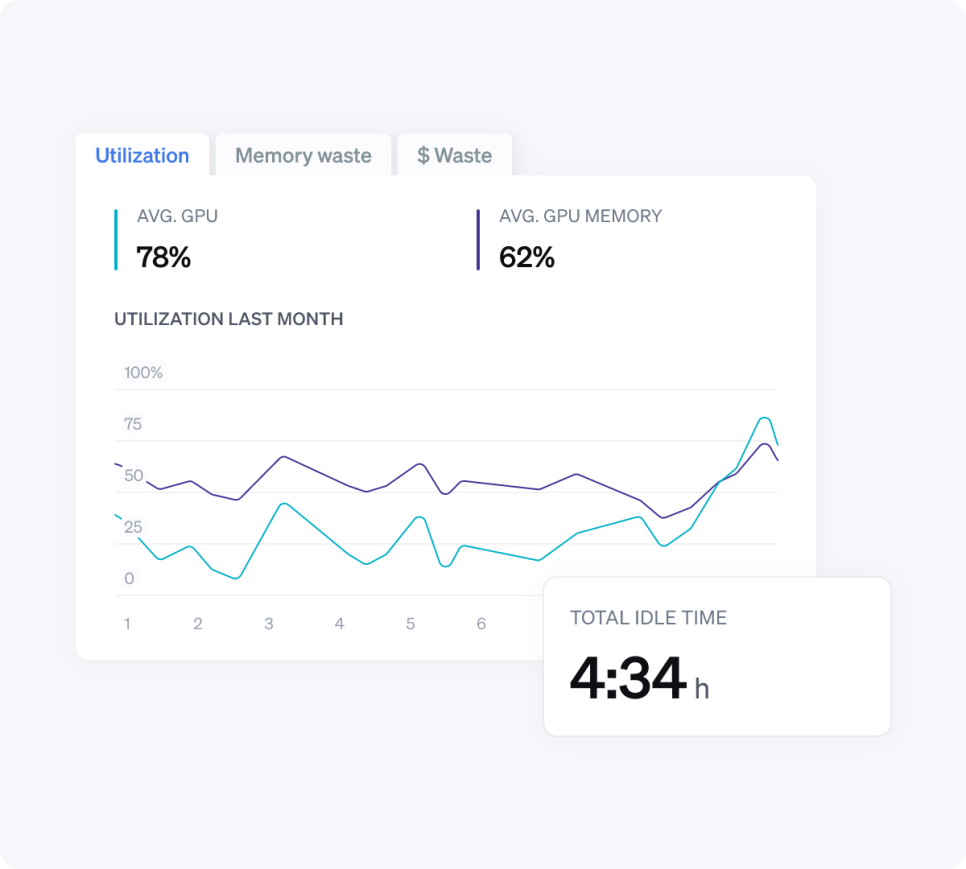
실제 적용 사례도 확인됩니다. 쿠버네티스에서 프로덕션 LLM 추론을 운영하는 생성형 AI 기업 Fairgen은 Cast AI 도입 후 모델 스택이나 서빙 프레임워크를 바꾸지 않고 GPU 인프라 비용을 70퍼센트 줄였습니다. 절감 요인은 노드 라이트사이징, 오토스케일링에 따른 노드 해제, 지연에 민감하지 않은 추론 작업에 대한 스팟 인스턴스 적용이었습니다.
☑️ 자주 묻는 질문
Q. LLM 추론 비용이 높아지는 가장 큰 원인은 무엇인가요?
유휴 GPU 용량입니다. Cast AI 2026 State of Kubernetes Optimization Report 기준 대부분의 프로덕션 쿠버네티스 클러스터는 GPU를 평균 5퍼센트 사용률로 운영합니다. GPU는 실제 사용률과 무관하게 시간당 요금 전액이 청구되므로, 배칭과 공유, 오토스케일링으로 이 격차를 줄일 때 가장 큰 절감이 발생합니다.
Q. 양자화를 적용하면 모델 출력 품질이 떨어지나요?
떨어집니다. 정밀도를 낮추면 반올림 오차가 생깁니다. H100의 FP8은 BF16 대비 MMLU 정확도 하락이 대체로 1퍼센트 미만이고, A100의 AWQ는 1~3퍼센트, INT4(GPTQ/GGUF)는 3~6퍼센트 수준입니다. 프로덕션 배포 전에 실제 모델과 과제로 벤치마크를 거치는 과정이 필요합니다.
Q. A100 80GB 한 장에서 70B 모델을 운영할 수 있나요?
AWQ 4비트 양자화를 적용하면 가능합니다. 가중치가 약 35~37GB로 줄어 80GB 디바이스에서 KV 캐시와 활성값에 약 40GB가 남습니다. INT8은 파라미터당 1바이트를 유지하므로 70B 모델이 약 70GB가 되어 KV 캐시 여유가 거의 없습니다. 네이티브 하드웨어 가속을 받는 FP8 추론이 필요하면 H100 80GB나 H200이 필요합니다.
Q. MIG 파티션으로 70B 모델의 텐서 병렬 처리를 구성할 수 있나요?
불가능합니다. MIG 파티션은 하드웨어 수준에서 격리되어 있어 동일 물리 GPU의 MIG 인스턴스 간 NVLink와 P2P CUDA 통신이 비활성화됩니다. 텐서 병렬 처리는 GPU 간 고속 통신을 전제로 하므로, TP-2 이상이 필요하다면 MIG 파티션이 아니라 NVLink로 연결된 물리 GPU를 사용해야 합니다.
Q. HPA만으로 GPU 비용을 줄일 수 있나요?
한계가 있습니다. HPA는 파드를 축소하지만 하단 노드는 과금을 계속합니다. GPU 비용을 실제로 줄이려면 파드 축소가 노드 해제까지 이어져야 합니다. Cast AI 워크로드 오토스케일링은 마지막 레플리카가 내려갈 때 하단 GPU 노드를 해제해 과금을 중단합니다.
☑️ 마무리
LLM 추론 비용은 GPU를 얼마나 확보했는지가 아니라 확보한 GPU를 요청 사이에 얼마나 놀리지 않는지에서 갈립니다. GPU 공유로 한 장에 여러 워크로드를 태우고, 연속 배칭으로 요청 간 공백을 없애고, 양자화로 메모리 요구량을 줄이고, 라이트사이징으로 요청과 실사용의 간격을 좁히고, 오토스케일링으로 유휴 노드를 해제하는 다섯 가지가 모두 같은 방향을 향합니다. 평균 5퍼센트와 최고 49퍼센트의 격차는 하드웨어를 바꾸지 않고도 좁힐 수 있는 폭입니다.
다만 이 다섯 가지를 각각의 도구와 설정으로 나눠 운영하면 관리 부담이 그만큼 늘어납니다. Cast AI는 GPU 공유와 배치, 라이트사이징, 노드 라이프사이클 관리를 하나의 제어 평면에서 자동으로 처리하며, 비용을 보여주는 데서 그치지 않고 실제 조치까지 수행합니다. 클라우드네트웍스는 Cast AI의 국내 파트너로서 고객 환경에 맞춘 도입 검토부터 구축, 운영까지 함께합니다. AI 워크로드 확대와 함께 GPU 비용 관리를 고민중이시라면 클라우드네트웍스로 문의해 주세요.
▶ Cast AI 자세히보기
[출처 : CAST AI, "LLM Inference Cost Optimization: Run AI Inference for Less", https://cast.ai/blog/llm-inference-cost-optimization/, CAST AI, "GPU Optimization for AI Infrastructure", https://cast.ai/gpu-optimization/, CAST AI, "GPU Sharing", https://cast.ai/gpu-sharing/, CAST AI, "Cross-Cloud GPU Access", https://cast.ai/cross-cloud-gpu-access/, CAST AI, "Kubernetes Workload Optimization & Rightsizing", https://cast.ai/workload-optimization/, CAST AI, "Multi-Cloud and Cross-Region GPU Capacity for Kubernetes AI", https://cast.ai/blog/multi-cloud-gpu-kubernetes/, CAST AI, "GPU sharing methods", https://docs.cast.ai/docs/gpu-sharing, CAST AI, "Multi-Instance GPU (MIG)", https://docs.cast.ai/docs/gpu-sharing-mig, CAST AI, "What is OMNI?", https://docs.cast.ai/docs/omni-overview, CAST AI, "2026 State of Kubernetes Optimization Report", https://cast.ai/reports/state-of-kubernetes-optimization/]