

쿠버네티스(Kubernetes) 클러스터를 운영하는 조직에서 클라우드 비용이 예상보다 빠르게 증가하는 원인은 대부분 컴퓨트 계층에 있습니다. 워크로드가 실제로 사용하는 리소스보다 큰 노드가 계속 떠 있고, 트래픽이 줄어든 뒤에도 그 노드가 그대로 유지되는 구조가 반복되기 때문입니다. 기존의 노드 그룹 기반 오토스케일링은 이 문제를 완전히 해결하기 어렵습니다. 인스턴스 타입과 그룹 크기를 미리 정의해 두고 그 범위 안에서만 확장과 축소가 일어나기 때문에, 실제 스케줄링 요구와 노드 사양 사이에 간극이 남습니다.
카펜터(Karpenter)는 이 간극을 노드 계층에서 줄이기 위해 만들어진 오픈소스 프로젝트입니다. 다만 남는 간극이 노드 계층에만 있는 것은 아닙니다. 이 글에서는 Karpenter의 동작 방식과 컨솔리데이션을 정리하고, 노드 계층 밖에 남는 부분을 캐스트 AI(Cast AI)의 Karpenter Enterprise Suite가 어떻게 보완하는지 살펴봅니다.
☑️ Karpenter란 무엇인가
Karpenter는 스케줄되지 못한 파드를 감시해 필요한 시점에 적정 사양의 노드를 클라우드 API에서 직접 프로비저닝하는 오픈소스 쿠버네티스 노드 오토스케일러입니다. 미리 정의된 노드 그룹을 확장하는 대신, 각 스케줄링 이벤트마다 가장 적합하고 비용이 낮은 인스턴스를 선택합니다. 수요가 줄어들면 워크로드를 더 적은 수의 노드로 재배치해 유휴 컴퓨트 비용을 줄입니다.
AWS는 2021년 Karpenter를 개발해 오픈소스로 공개했습니다. 2023년 프로젝트가 베타 단계로 승격되었고, AWS는 벤더 중립 코어를 쿠버네티스 오토스케일링 SIG(Kubernetes Autoscaling Special Interest Group)를 통해 CNCF에 기여했습니다. v1.0은 2024년 정식 출시되었으며, 작성 시점 기준 최신 버전은 v1.14입니다.
Karpenter는 HPA(Horizontal Pod Autoscaler), VPA(Vertical Pod Autoscaler)와 함께 쿠버네티스 오토스케일링 생태계를 구성하지만, 담당 영역은 노드 계층입니다. 몇 개의 머신이 실행되는지, 사양은 어떠한지, 수요가 줄었을 때 얼마나 빠르게 종료되는지를 다룹니다.
☑️ Karpenter가 노드를 프로비저닝하는 방식
스케줄되지 못한 파드 감시
Karpenter는 컨트롤러를 통해 쿠버네티스 API에서 Unschedulable 상태의 파드를 감시합니다. 기존 노드 중 어느 것도 해당 파드를 수용할 수 없으면 스케줄러가 파드를 pending 상태로 표시하고, 이 시점에서 Karpenter가 파드의 리소스 요청, 노드 셀렉터, 톨러레이션, 어피니티 규칙을 평가합니다. 그리고 모든 제약 조건을 만족하는 인스턴스 타입 중 가장 작고 저렴한 것을 선택해 프로비저닝합니다. 고객 환경에서 이 방식이 갖는 의미는 노드 사양 결정 시점이 앞당겨진다는 점입니다. 운영자가 사전에 인스턴스 타입을 예측해 정의해 둘 필요 없이, 실제 스케줄링 요구가 발생한 시점의 조건으로 노드가 결정됩니다.
Karpenter의 인스턴스 타입 선택 범위
Karpenter가 기존 오토스케일러와 크게 달라지는 지점은 인스턴스 선택 범위입니다. Karpenter는 수백 개의 인스턴스 타입을 패밀리와 사이즈를 가로질러 동시에 평가합니다. 예를 들어 파드가 4 vCPU와 8 GiB 메모리를 요구한다면, 그 기준을 충족하는 모든 인스턴스 타입을 검토해 현재 비용 기준으로 순위를 매기고 가장 적합한 인스턴스를 프로비저닝합니다. 이 과정에서 스팟 인스턴스 가용성, 리전별 가격, NodePool에 정의된 용량 타입 선호도가 함께 반영됩니다. 기대 효과는 프로비저닝 초기 단계부터 빈 패킹(bin-packing) 품질이 높아진다는 점입니다. 워크로드를 노드 사양에 맞추는 것이 아니라, 노드를 워크로드에 맞춰 생성하는 구조이기 때문입니다.
저스트 인 타임 프로비저닝과 노드 그룹 방식의 차이
기존 노드 그룹 오토스케일링은 인스턴스 타입과 그룹 크기를 사전에 정의해야 하고, 오토스케일러는 그 그룹 단위로 확장과 축소를 수행합니다. 그 결과 실제 실행 중인 워크로드에 비해 지나치게 큰 노드가 남는 상황이 자주 발생합니다. 반면 Karpenter에는 노드 그룹 개념이 없습니다. 스케줄링 이벤트마다 필요한 노드를 저스트 인 타임으로 생성하고, 워크로드가 더 이상 해당 노드를 필요로 하지 않으면 디프로비저닝합니다. 노드 라이프사이클이 짧아지면서 유휴 컴퓨트 비용도 함께 줄어듭니다.
☑️ 컨솔리데이션과 빈 패킹
노드를 제거하고 재배치하는 방식
컨솔리데이션(Consolidation)은 Karpenter가 유휴 컴퓨트를 회수하는 메커니즘입니다. 컨솔리데이션은 지속적으로 실행되면서 노드가 비어 있거나 사용률이 낮은지 확인합니다. 대상 노드를 식별하면 해당 노드의 파드를 축출하고 노드를 종료한 뒤, 워크로드를 남은 노드에 다시 스케줄링합니다.
어떤 노드를 대상으로 볼지는 consolidationPolicy 값으로 결정하며 세 가지를 선택할 수 있습니다. 설정하지 않으면 consolidationPolicy는 WhenEmptyOrUnderutilized, consolidateAfter는 0s가 기본값으로 적용됩니다.
WhenEmpty는 비어 있는 노드만 대상으로 합니다. 여기서 비어 있다는 것은 데몬셋처럼 디스럽션 비용이 없는 파드만 남은 상태를 의미합니다. 세 정책 중 가장 보수적인 동작 방식입니다.
WhenEmptyOrUnderutilized는 제거하거나 교체해 비용을 줄일 수 있는 모든 노드를 대상으로 합니다. 절감 폭은 가장 크지만 그만큼 파드 디스럽션을 감수해야 합니다.
Balanced는 절감액과 파드 디스럽션을 함께 점수화해, 절감 효과가 디스럽션에 비해 충분히 클 때만 컨솔리데이션을 실행합니다. 비어 있거나 사용률이 명확히 낮은 노드는 그대로 정리하되, 절감 폭이 작은 한계적인 조치는 건너뜁니다. 워크로드 변동이 잦아 잦은 노드 교체가 부담스러운 클러스터에 적합한 선택지입니다.
Cast AI가 공개한 2026 State of Kubernetes Optimization Report 기준으로, 쿠버네티스 클러스터의 평균 CPU 사용률은 8%이며 클러스터 전반의 CPU 오버프로비저닝은 69% 수준입니다. Karpenter의 저스트 인 타임 프로비저닝과 컨솔리데이션은 이 낭비 중 노드 계층에 해당하는 부분을 직접 다룹니다. 다만 낮은 사용률에는 과도하게 요청된 파드 리소스도 반영되어 있으며, 이 부분은 Karpenter 단독으로 해결되지 않습니다.
디스럽션 제어
컨솔리데이션은 효과가 큰 만큼, 축출이 과도하면 운영 중인 워크로드에 영향을 줄 수 있습니다. Karpenter는 두 가지 제어 수단을 제공합니다. consolidateAfter는 노드에 새 작업이 들어오기를 기다리는 시간입니다. 노드에 파드가 추가되거나 제거될 때마다 타이머가 초기화되므로, 노드는 이 시간만큼 안정적인 상태를 유지한 뒤에야 컨솔리데이션 후보가 됩니다. 값을 길게 잡으면 변동이 잦은 워크로드가 안정화될 여유가 생기고 컨솔리데이션 빈도는 줄어듭니다. Never로 설정하면 해당 NodePool의 컨솔리데이션이 비활성화됩니다.
두 번째는 디스럽션 버짓입니다. budgets 배열을 사용하면 디스럽션 속도를 세밀하게 제어할 수 있습니다.
disruption: |
첫 번째 항목은 동시 디스럽션 대상을 전체 노드의 10%로 제한합니다. 두 번째 항목은 크론 스케줄과 지속 시간으로 적용 구간을 지정한 버짓으로, 해당 시간대에는 5개라는 상한이 추가로 적용됩니다. 버짓이 여러 개인 경우 Karpenter는 가장 제한적인 값을 적용합니다. 버짓을 정의하지 않으면 nodes: 10% 하나가 기본값으로 적용됩니다.
파드 단위 제어도 함께 동작합니다. 차단 상태의 PodDisruptionBudget(PDB)이 적용된 파드는 축출되지 않으며, 해당 파드가 있는 노드는 자발적 디스럽션 대상에서 제외됩니다. 한 노드의 파드들이 서로 다른 PDB에 속한 경우 모든 PDB가 동시에 축출을 허용해야 하므로, 노드에 걸린 PDB가 많을수록 컨솔리데이션 기회는 줄어듭니다. 금융, 제조, 공공처럼 서비스 중단 허용 범위가 좁은 환경에서는 이 설정값을 어떻게 잡느냐가 도입 검토의 핵심 항목이 됩니다.
☑️ Karpenter의 핵심 구성 요소
NodePool과 NodeClass
Karpenter는 두 개의 핵심 CRD를 사용합니다. NodePool은 아키텍처, 용량 타입, 인스턴스 패밀리 같은 스케줄링 제약 조건과 리소스 한도, 디스럽션 정책을 정의합니다. NodeClass는 클라우드 제공자 측 인프라 설정을 정의하며, AWS에서는 EC2NodeClass가 AMI 선택, 서브넷, 보안 그룹, IAM 역할을 지정합니다. 이 분리는 의도된 설계입니다. 플랫폼 팀이 클라우드 설정에 해당하는 NodeClass를 소유하고, 개별 팀은 자신들의 워크로드에 맞는 NodePool 제약 조건을 정의합니다. 인프라 정책은 중앙에서 관리하면서 워크로드 스케줄링 정책은 팀 단위로 유연하게 가져갈 수 있는 구조입니다.
다음 NodePool 예시는 amd64 인스턴스에서 온디맨드와 스팟 용량을 모두 허용하고, 클러스터 CPU 한도를 1,000으로 설정하며, 10% 노드 디스럽션 버짓과 함께 WhenEmptyOrUnderutilized 컨솔리데이션을 활성화합니다.
| apiVersion: karpenter.sh/v1 kind: NodePool metadata: name: default spec: template: spec: requirements: - key: kubernetes.io/arch operator: In values: ["amd64"] - key: karpenter.sh/capacity-type operator: In values: ["on-demand", "spot"] nodeClassRef: group: karpenter.k8s.aws kind: EC2NodeClass name: default limits: cpu: "1000" disruption: consolidationPolicy: WhenEmptyOrUnderutilized budgets: - nodes: "10%" |
이와 짝을 이루는 EC2NodeClass는 AMI 별칭, IAM 역할, 서브넷과 보안 그룹 셀렉터를 지정합니다.
apiVersion: karpenter.k8s.aws/v1 |
드리프트가 발생했을 때의 동작
드리프트(Drift)는 노드의 실행 중 구성이 NodePool 사양과 달라진 상태를 의미합니다. 새로운 AMI 버전이 제공되거나 요구 조건이 변경되면 Karpenter는 해당 노드를 드리프트 상태로 표시하고 자동으로 교체합니다. 수동 롤아웃이나 블루-그린 방식의 노드 그룹 관리 없이 선언된 구성과 실제 노드 상태를 일치시킬 수 있습니다.
☑️ Karpenter와 Cluster Autoscaler의 차이
두 방식의 핵심 차이는 동작 범위입니다. 클러스터 오토스케일러(Cluster Autoscaler)는 고정된 인스턴스 타입을 가진 사전 정의 노드 그룹을 확장합니다. 반면 Karpenter는 클라우드 API에서 개별 노드를 직접 프로비저닝하며, 가용한 모든 인스턴스 타입 중에서 선택합니다. 운영 관점에서 보면 Cluster Autoscaler는 사전에 구성된 그룹 경계 안에서만 동작하는 반면, Karpenter는 스케줄링 이벤트에 반응해 최적 인스턴스 타입을 선택합니다. 디프로비저닝 역시 Karpenter는 컨솔리데이션 로직으로 자체 처리하지만, Cluster Autoscaler는 그룹 단위 스케일 다운 휴리스틱에 의존합니다.
다만 Cluster Autoscaler는 AWS 이외의 클라우드에서 더 성숙한 편이며, 일부 환경에서는 커뮤니티 지원 범위가 넓습니다. 선택 기준은 사용 중인 클라우드 제공자와 노드 그룹 템플릿을 수동으로 유지 관리할 의향이 어느 정도인지에 따라 달라집니다.
☑️ 클라우드 환경별 Karpenter 지원 현황
Karpenter는 AWS에서 가장 폭넓게 지원됩니다. EKS Auto Mode는 2024년 AWS re:Invent에서 발표되어 2024년 12월 GA에 도달했으며, 신규 EKS 클러스터는 별도의 Helm 설치나 컨트롤러 배포 없이 Karpenter를 활성화할 수 있습니다.
Azure AKS는 2024년 하반기에 Node Auto Provisioning을 통한 Karpenter 기반 노드 프로비저닝이 정식 출시되었습니다. Azure 프로바이더는 일반적인 워크로드 패턴 대부분을 지원하며, AWS 프로바이더와 동일한 NodePool CRD 구조를 사용합니다.
GCP와 GKE는 상황이 다릅니다. 작성 시점 기준 GKE용 공식 Karpenter 프로바이더는 존재하지 않습니다. 커뮤니티가 관리하는 옵션은 있으나 프로덕션 지원이 없고 AWS 및 Azure 프로바이더와 기능 동등성을 갖추지 못한 상태입니다. GCP 환경에서 운영하는 조직이라면 Karpenter 도입을 확정하기 전에 다른 노드 오토스케일링 방식을 함께 검토할 필요가 있습니다.
☑️ Karpenter만으로 해결되지 않는 영역
인트로에서 말한 노드 계층 밖에 남는 부분이 여기에 해당합니다. Karpenter는 노드 프로비저닝과 컨솔리데이션 영역에서 효과적이지만, 자체적으로 다루기 어려운 세 가지가 있습니다.
가장 흔한 간극은 과도하게 요청된 파드입니다. 컨테이너가 4 CPU를 요청하고 실제로는 0.3만 사용하더라도, Karpenter는 요청값 전체를 수용할 수 있는 크기의 노드를 프로비저닝합니다. 파드가 요구하는 값과 실제 소비량 사이의 차이는 노드 프로비저닝 문제가 아니라 파드 리소스 요청 문제이기 때문입니다.
스테이트풀 워크로드는 다른 제약을 받습니다. Karpenter가 컨솔리데이션을 수행할 때는 파드를 축출합니다. 중단을 허용하는 스테이트리스 워크로드에서는 문제가 되지 않지만, 지속 연결이나 로컬 스토리지를 사용하는 스테이트풀 워크로드에서는 축출이 곧 다운타임으로 이어질 수 있습니다.
세 번째는 스팟 인스턴스 리스크입니다. Karpenter는 중단 신호를 사후 대응 방식으로 처리하며, 클라우드 제공자가 어떤 스팟 인스턴스를 회수할지 예측하는 ML 기반 기능은 갖고 있지 않습니다.
☑️ Cast AI - Karpenter Enterprise Suite가 보완하는 영역
Karpenter Enterprise Suite는 Cast AI가 2026년 5월 정식 출시한 상용 제품으로, Karpenter 채택이 가장 활발한 AWS 기반 쿠버네티스 클러스터를 대상으로 설계되었습니다.
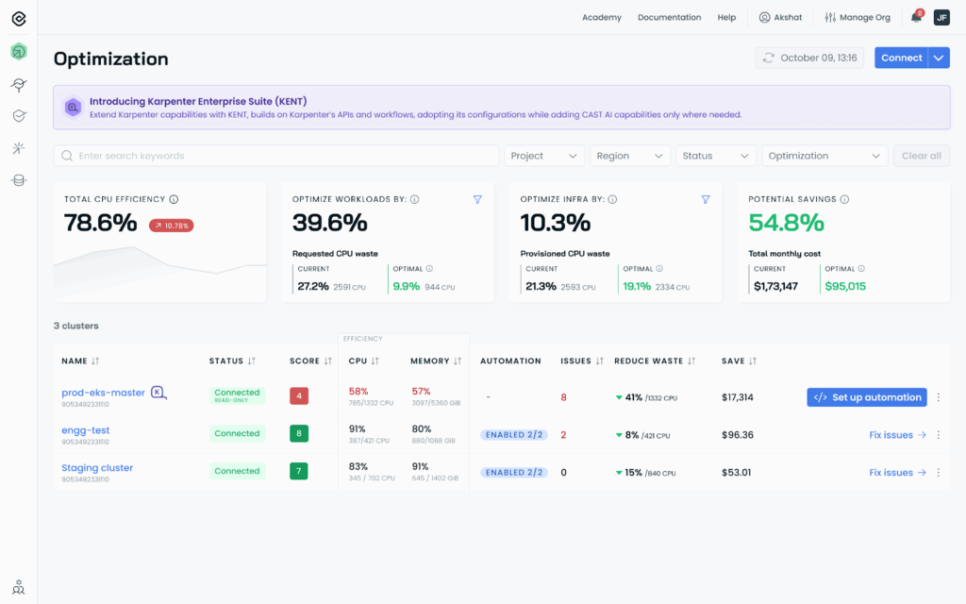
이 제품의 전제는 Karpenter를 대체하지 않는다는 점입니다. Karpenter는 그대로 오토스케일러 역할을 유지하며 노드 라이프사이클 조치를 실행하고, Cast AI는 그 위에 분석과 최적화, 자동화 계층을 더합니다. 기존 NodePool과 EC2NodeClass는 그대로 기준값(source of truth)으로 남으며, 최적화 기능이 활성화되면 Cast AI가 해당 CRD를 읽고 수정해 프로비저닝 판단에 반영합니다. 도입은 Karpenter 위에 경량 에이전트를 배포하는 스크립트 실행으로 시작합니다. 기존 Karpenter 환경을 다시 구성할 필요가 없어, 이미 운영 중인 조직뿐 아니라 Karpenter를 막 도입한 조직도 대상이 됩니다. 클러스터를 연결하면 Cast AI가 Karpenter 실행 여부를 자동으로 감지하고 워크로드 사용량, 노드 선택, 스팟 동작, 클러스터 전반의 효율을 평가합니다.
자동화 수준은 조직이 결정합니다. 최적화 기회를 제안받는 수준으로 사용할 수 있고, 라이트사이징이나 컨솔리데이션, 리밸런싱, 스팟 처리를 자동 실행하도록 설정할 수도 있습니다. 절감 가능 규모를 먼저 확인한 뒤 준비된 기능부터 순차적으로 켜는 방식이 가능합니다. 이러한 판단은 수만 개의 연결된 클러스터에서 수집한 워크로드 동작, 리소스 사용량, 스팟 시장 상황을 학습한 머신러닝 모델을 기반으로 합니다. 이 모델은 리소스 수요를 예측하고, 안정적인 스팟 풀을 식별하며, 노드가 중단될 가능성을 감지하는 데 사용됩니다.
워크로드 라이트사이징
Karpenter는 파드의 요청값을 기준으로 노드를 확장합니다. 그런데 이 요청값은 실제 워크로드에 비해 과도하거나 부족하게 설정되는 경우가 많습니다. Cast AI는 일정 기간 실제 CPU와 메모리 사용량을 측정해 요청값을 조정합니다. 고객 환경에서 이 기능의 의미는 최적화 대상이 노드에서 파드로 확장된다는 점입니다. 파드가 실제 필요한 만큼만 요청하면 Karpenter가 프로비저닝하는 노드 사양도 함께 줄어듭니다. 반복적인 수동 튜닝 없이 낭비를 줄이면서 워크로드 안정성을 유지하는 것이 기대 효과입니다.
컨테이너 라이브 마이그레이션
대부분의 오토스케일러는 노드를 리밸런싱할 때 축출에 의존합니다. 이 방식은 스테이트풀 서비스, 스트리밍 애플리케이션, 대용량 JVM 워크로드에 영향을 줄 수 있습니다. Cast AI의 컨테이너 라이브 마이그레이션은 실행 중인 워크로드를 재시작하지 않고 새 노드로 이전합니다. 영구 스토리지를 사용해 기존에는 이동이 어려웠던 워크로드까지 이전 대상에 포함되며, 노드 단편화가 줄어들면서 빈 패킹 여지도 함께 늘어납니다.
이 기능은 지원되는 워크로드에 선택적으로 적용됩니다. 사용하지 않더라도 라이트사이징이나 스팟 관리 같은 다른 최적화 기능은 그대로 활용할 수 있습니다. 중단 허용 범위가 좁은 환경에서는 축출이 곧 다운타임으로 이어지던 워크로드까지 컨솔리데이션 대상에 포함할 수 있다는 점이 실무적인 차이입니다.
스팟 중단 예측과 용량 관리
스팟 인스턴스는 비용 절감 효과가 크지만 예측하기 어려운 중단이 워크로드에 영향을 줍니다. Cast AI는 스팟 동작을 분석해 중단 발생 가능성을 예측하고, 상대적으로 안정적인 스팟 풀을 평가합니다. 스팟 용량을 확보할 수 없는 상황에서는 워크로드를 온디맨드로 전환하고, 이후 스팟 용량이 다시 확보되면 되돌립니다. 운영 관점에서는 스팟 채택률을 높이면서도 담당자가 중단 대응에 투입하는 시간을 줄이는 효과를 기대할 수 있습니다.
지속적 리밸런싱과 배치 최적화
Karpenter는 노드를 효율적으로 프로비저닝하지만, 클러스터 사용 패턴은 하루 중에도 계속 변합니다. Cast AI의 리밸런서는 전체 노드에 걸쳐 워크로드가 어떻게 배치되어 있는지 분석하고, 사용률이 낮은 노드를 통합하면서 배치 로직으로 전체 분산을 개선합니다. 이때 배치 로직은 디스럽션 버짓과 워크로드 제약 조건을 함께 고려합니다. 개발과 스테이징 클러스터를 자동으로 하이버네이션해 유휴 지출을 없애는 기능도 함께 제공됩니다.
비용 가시성과 배분
Cast AI는 리소스 사용 현황과 그에 따른 비용을 상세하게 제공합니다. 라이트사이징, 스팟 활용, 컨솔리데이션으로 확보한 절감액을 확인할 수 있고, 워크로드와 네임스페이스, 팀 단위로 비용을 조회할 수 있습니다. 이 부분은 Karpenter 단독으로는 다루기 어려운 영역입니다. 엔지니어링 조직과 FinOps 조직이 서로 다른 기준으로 비용을 보는 상황에서, 팀 단위 차지백 근거를 동일한 데이터로 확보할 수 있다는 점이 실무적인 차이입니다.
정리하면 Karpenter는 노드 계층을, Cast AI는 그 위의 워크로드 계층을 담당하는 구조입니다. Cast AI는 Karpenter 위에 라이트사이징과 스팟 관리를 더한 고객이 일반적으로 30~70% 수준의 클라우드 비용 절감을 확인한다고 제시합니다.
☑️ 자주 묻는 질문
Karpenter는 무엇인가요?
Karpenter는 사전 정의된 노드 그룹 없이 필요한 시점에 적정 사양의 컴퓨트 노드를 프로비저닝하는 오픈소스 쿠버네티스 노드 오토스케일러입니다. 스케줄되지 못한 파드를 감시해 최적의 인스턴스 타입을 선택하고 클라우드 API를 직접 호출해 노드를 생성합니다. AWS가 2021년 개발해 2023년 쿠버네티스 오토스케일링 SIG를 통해 CNCF에 기여했으며, v1.0은 2024년 정식 출시되었습니다.
Karpenter는 어떤 방식으로 비용을 줄이나요?
두 가지 메커니즘으로 비용을 줄입니다. 첫째, 노드 생성 시점에 적정 사양의 노드를 프로비저닝해 과도하게 큰 인스턴스로 인한 낭비를 방지합니다. 둘째, 비어 있거나 사용률이 낮은 노드를 제거하고 워크로드를 더 적은 수의 머신으로 재배치하는 컨솔리데이션을 지속적으로 수행합니다. 컨솔리데이션 정책은 WhenEmpty, WhenEmptyOrUnderutilized, Balanced 세 가지이며 별도 설정이 없으면 WhenEmptyOrUnderutilized가 적용됩니다.
Karpenter는 AWS에서만 사용할 수 있나요?
아닙니다. Azure AKS에서도 2024년 하반기부터 Node Auto Provisioning을 통해 정식 지원됩니다. 다만 GKE의 경우 작성 시점 기준 공식 프로바이더가 없으며, 커뮤니티가 관리하는 프로바이더는 프로덕션 지원과 기능 동등성이 확보되지 않은 상태입니다.
Karpenter와 Cluster Autoscaler 중 무엇을 선택해야 하나요?
Cluster Autoscaler는 고정된 인스턴스 타입의 사전 정의 노드 그룹을 확장하고, Karpenter는 클라우드 API에서 개별 노드를 직접 프로비저닝하며 모든 인스턴스 타입 중에서 선택합니다. Karpenter가 빈 패킹 품질과 프로비저닝 속도에서 유리하지만, 해당 클라우드 제공자의 Karpenter 노드 프로바이더 지원이 전제 조건입니다.
Karpenter Enterprise Suite는 무엇인가요?
Karpenter Enterprise Suite는 오픈소스 Karpenter에 워크로드 단위 최적화, 안전한 컨솔리데이션, 스팟 인텔리전스, 비용 가시성을 더하는 Cast AI의 상용 제품입니다. 노드 프로비저닝은 Karpenter가 계속 담당하고, Cast AI가 효율과 안정성을 높이는 자동화와 판단 로직을 추가합니다.
Cast AI는 Karpenter를 대체하나요?
대체하지 않습니다. Karpenter는 노드 오토스케일러 역할을 그대로 유지하며, Cast AI는 그 옆에서 스케일링과 컨솔리데이션 판단을 보강하고 노드 라이프사이클 조치는 Karpenter가 실행합니다. 클러스터를 연결하면 Cast AI가 Karpenter를 자동으로 감지해 워크로드 사용량, 노드 선택, 스팟 동작, 클러스터 전반의 효율을 평가합니다.
Cast AI는 Karpenter가 해결하지 못하는 어떤 문제를 다루나요?
Karpenter는 노드 프로비저닝에 집중합니다. Cast AI는 실제 사용량 기반의 워크로드 라이트사이징, 컨테이너 라이브 마이그레이션을 활용한 안전한 컨솔리데이션, 예측 기반 스팟 처리, 지속적 리밸런싱, 워크로드와 팀 단위의 비용 및 효율 가시성을 추가합니다.
컨테이너 라이브 마이그레이션은 반드시 사용해야 하나요?
필수는 아닙니다. 컨테이너 라이브 마이그레이션은 지원되는 워크로드에 선택적으로 적용되며, 컨솔리데이션과 리밸런싱 과정의 중단 영향을 줄이는 데 도움이 됩니다. 이 기능을 사용하지 않아도 Cast AI의 다른 최적화 기능은 그대로 활용할 수 있습니다.
Cast AI는 조치를 자동으로 실행하나요, 제안만 제공하나요?
두 가지 모두 가능합니다. 최적화 기회를 제안하는 방식으로 사용할 수 있고, 설정에 따라 라이트사이징, 컨솔리데이션, 리밸런싱, 스팟 처리를 자동으로 실행하도록 할 수도 있습니다. 자동화를 어느 범위까지 적용할지는 운영 조직이 결정합니다.
Karpenter Enterprise Suite는 어떤 조직을 대상으로 하나요?
이미 Karpenter를 운영 중인 조직과 도입을 검토하거나 막 시작한 조직 모두를 대상으로 합니다. 온보딩은 Karpenter 위에 경량 에이전트를 배포하는 스크립트 실행으로 진행되며 기존 Karpenter 환경을 다시 구성할 필요가 없습니다. 대상 환경은 Karpenter 채택이 가장 활발한 AWS 기반 쿠버네티스 클러스터입니다.
☑️ 마무리
Karpenter는 쿠버네티스 비용 구조에서 노드 계층의 낭비를 줄이는 방식으로 자리 잡았습니다. 스케줄링 이벤트 단위로 인스턴스를 선택하고, 사용률이 낮은 노드를 지속적으로 회수하는 구조는 노드 그룹 기반 오토스케일링이 남기는 간극을 좁힙니다. 다만 파드 리소스 요청 과다, 스테이트풀 워크로드 축출, 스팟 중단 예측처럼 노드 계층 밖의 과제는 Karpenter 위에 별도의 최적화 계층이 필요합니다.
클라우드네트웍스는 Cast AI를 기반으로 Karpenter 운영 환경의 비용 최적화 도입을 지원하고 있습니다. Karpenter를 이미 운영 중이라면 기존 NodePool과 EC2NodeClass 구성을 유지한 상태에서 Karpenter Enterprise Suite를 적용해 워크로드 라이트사이징, 스팟 안정성, 팀 단위 비용 가시성까지 최적화 범위를 넓힐 수 있습니다. 현재 클러스터의 사용률과 절감 가능 구간을 확인하고자 하신다면 클라우드네트웍스로 문의해 주시기 바랍니다.
▶ Cast AI 자세히보기
[출처 : CAST AI, "What Is Karpenter? How Just-in-Time Node Provisioning Cuts Kubernetes Cost", https://cast.ai/blog/what-is-karpenter/, CAST AI, "Karpenter Just Got Smarter: Cast AI Brings Enterprise-Grade Optimization to Kubernetes Autoscaling", https://cast.ai/blog/cast-ai-for-karpenter/, CAST AI, "Karpenter Enterprise suite | Overview", https://docs.cast.ai/docs/karpenter-enterprise, CAST AI, "Karpenter Optimization with Automation Guardrails", https://cast.ai/karpenter-optimization/, Karpenter, "Disruption", https://karpenter.sh/docs/concepts/disruption/, CNCF, "What Karpenter v1.0.0 means for Kubernetes autoscaling", https://www.cncf.io/blog/2024/11/06/karpenter-v1-0-0-beta/]